▲ Caso 04 · Atendimento automático em produção
Três camadas de robô, e a mais barata resolve a maioria
Mandar toda mensagem para um modelo de linguagem custa por token, demora, e devolve respostas diferentes para a mesma pergunta. A arquitetura inverte isso: o modelo caro só entra onde existe julgamento de verdade.
- Período
- 2026
- Meu papel
- concepção, arquitetura e código
- Onde roda
- Cloudflare Workers e GitHub Actions
- Estado
- em produção, 4 páginas no ar
A conversa, como ela aconteceu
Domingo, 19h16. Um eletricista pediu um checklist da NR 10 em Excel. O robô respondeu no mesmo minuto, explicou o que tinha e o que não tinha, e ofereceu o Kit. Lembrou que ele já tinha baixado o card de bitola. Quando ele perguntou se tinha foto, o robô mandou dois vídeos do material e o link de pagamento.
Às 19h27 ele respondeu que pagaria no fim de semana seguinte, e o robô encerrou sem pressionar. Doze minutos de conversa, sem ninguém da equipe no meio.
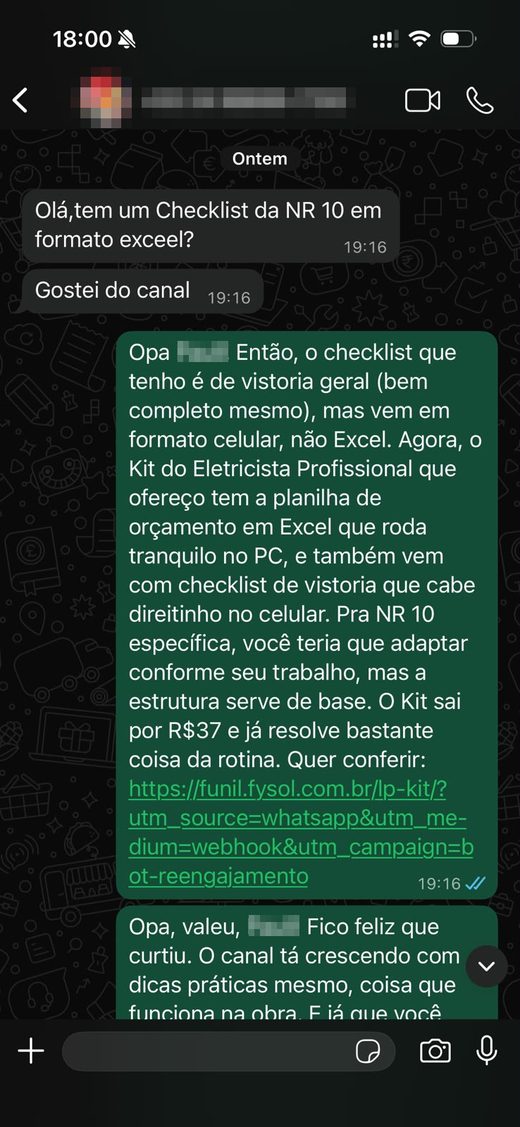
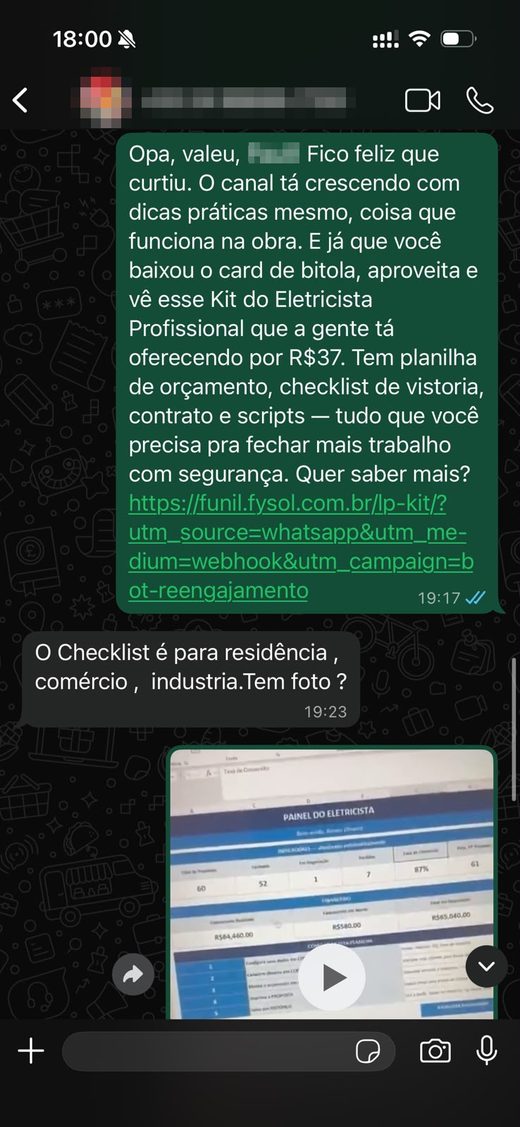
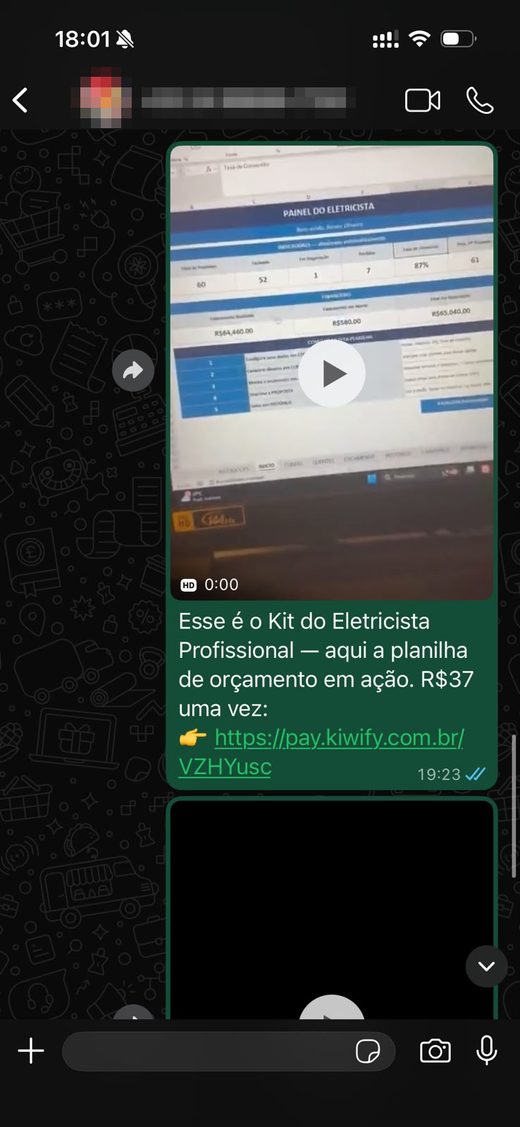
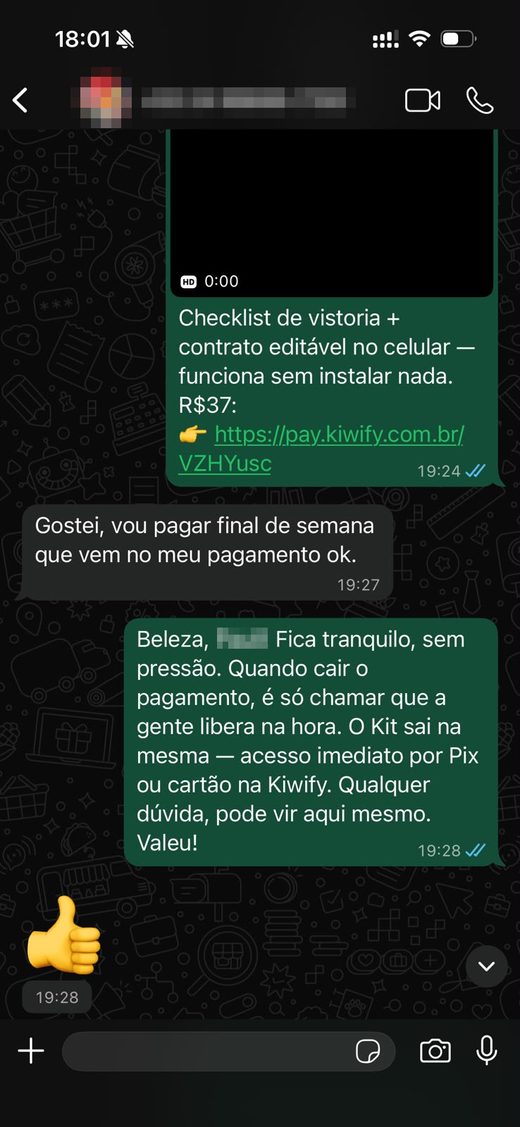
Telas reais do WhatsApp, agosto de 2026. Nome e foto do cliente pixelados.
Como está construído
- Recepção
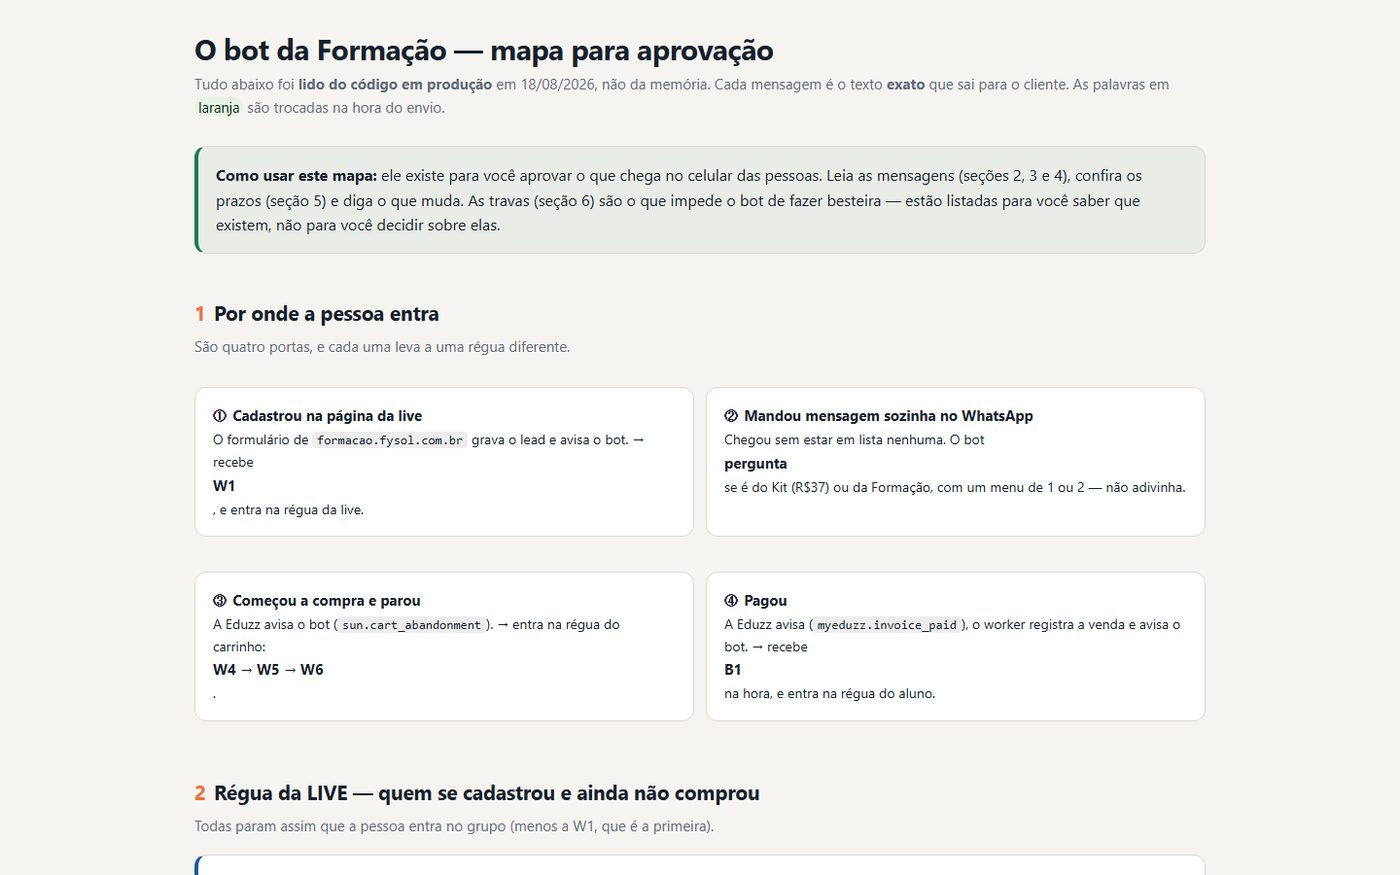
- Um Cloudflare Worker de 7.859 linhas recebe cada mensagem em tempo real pela integração de WhatsApp e responde na mesma requisição.
- Camada 1
- Classificador determinístico em JavaScript, com intenções declaradas em tabela. Custo zero por mensagem e resposta idêntica para a mesma pergunta.
- Camada 2
- Modelo rápido que devolve
{"acao": "enviar_pdf"}em JSON quando reconhece um pedido de material, em vez de devolver texto. O parse tem saída graciosa: se o JSON não vier, o texto bruto ainda é aproveitado. - Camada 3
- Modelo forte, acionado apenas no que sobra das duas primeiras.
- Base de conhecimento
- Uma camada de recuperação alimenta o modelo com o conteúdo real dos materiais. Quando ela falha, o robô segue sem ela em vez de derrubar a resposta.
- Checkout
- Webhook de plataforma de pagamento com segredo próprio, e um espelho que replica os eventos do funil para auditoria posterior.
- Estado do lead
- Cloudflare D1 para o histórico e KV para o estado rápido, com a chave canônica do lead como única identidade.
- Régua de contato
- Python em GitHub Actions para a sequência programada, com guarda de horário comercial.
- Ritmo de envio
- Intervalo sorteado entre mensagens, com a função de espera injetada como parâmetro, para que a suíte de testes exercite o ritmo sem dormir de verdade.
- Páginas
- Quatro landing pages estáticas no ar, cada uma atacando uma dor específica de quem trabalha com instalação elétrica.
As decisões, e o que eu descartei em cada uma
Quem responde é o webhook, e não o processo agendado
O Worker recebe a mensagem e responde na hora. O processo em GitHub Actions cuida apenas da sequência programada de reengajamento, que é saída e não conversa.
Por quê: um processo agendado não tem como capturar resposta em tempo real. Quem escreve espera resposta em segundos, não no próximo ciclo.
O modelo devolve ação estruturada, não prosa
Quando alguém escreve "manda aê", nenhuma lista de palavras cobre todas as variações informais. O modelo entende a intenção, mas antes só sabia responder com texto de venda, quando o que a pessoa queria era o arquivo.
A camada 2 passou a devolver um campo de ação em JSON. O chamador verifica a ação antes de olhar qualquer texto.
O que eu descartei: continuar enumerando formas de pedir na camada determinística. É uma lista que nunca fecha.
O telefone tem uma forma canônica, e ela vale em todo componente
Todo componente que cruza mensagens por telefone normaliza o número antes de comparar. A chave do lead é essa forma canônica, e é a única identidade da pessoa no banco e no estado.
O que isso corrigiu, medido: a base tinha 350 fichas para 252 pessoas, com 98 duplicadas. E o processo que vigiava a linha comparava o identificador cru: reportou zero respostas enquanto o robô estava respondendo normalmente.
Identificador que chega em mais de um formato precisa de forma canônica antes de virar chave. Sem isso o sistema mente com autoridade.
A pausa humana expira sozinha em doze horas
Quando alguém do time assume a conversa, o robô se cala. Essa pausa deixa de valer doze horas depois, automaticamente.
Por quê doze: um atendimento humano cabe num dia de trabalho. Sem prazo, a pausa ficava até alguém lembrar de liberar, e o lead pausado por engano nunca mais recebia nada.
O que eu descartei: pausa permanente até liberação manual. Ela transforma um esquecimento de trinta segundos num lead perdido para sempre.
Quando as três camadas falham, o robô admite
O robô diz que não entendeu, oferece três caminhos concretos para a pessoa escolher, e avisa uma pessoa por Telegram.
Por quê: uma resposta honesta custa menos que uma resposta errada dada com confiança. O modelo sempre tem o que dizer, e é justamente esse o risco.
O bug que ensinou mais que o acerto
Em determinado momento o robô parou de responder. Sem erro, sem alarme, sem nada no monitoramento: a requisição respondia normalmente e a mensagem simplesmente não saía.
A causa era uma regra da plataforma que eu não conhecia. O processamento assíncrono do Cloudflare Workers tem prazo para terminar depois que a resposta HTTP é devolvida. Eu tinha posto uma espera de quinze segundos antes de processar, para agrupar mensagens que a pessoa manda picadas. Essa espera consumia o orçamento inteiro antes de qualquer chamada acontecer.
O diagnóstico não veio do código nem do log de aplicação. Veio de abrir o fluxo ao vivo da plataforma e ver onde o processo era interrompido.
Sistema que falha em silêncio é pior que sistema que quebra alto. O que respondia 200 estava entregando nada.
Contagem feita no repositório em 22/09/2026.